Обновлено: 17 октября 2026
Токен — один из фрагментов, на которые модель делит текст: часть слова, слово или знак. API позволяет программе отправлять запросы модели, а расход таких запросов часто считают в токенах. Число токенов зависит от токенизатора — способа разбиения текста, поэтому одинаковый документ может занимать разный объём у разных моделей и версий. Для расчёта стоимости нужны не только размер текста и ставка, но и правила учёта входа, ответа, рассуждений и кэша.
Почему слово не равно токену
Текст делится на фрагменты: ими могут быть части слов, целые слова, знаки и другие последовательности. Поэтому пересчёт «одно слово — один токен» не подходит для точной сметы. Язык, код, таблицы и повторяющиеся символы могут давать разное соотношение длины текста и числа токенов.
При смене модели меняется и способ разбиения. В документации Haiku 5.5 Anthropic отдельно предупреждает о новом токенизаторе и увеличении числа токенов для того же содержимого по сравнению с Haiku 4.5. Значит, прежнюю статистику нельзя без проверки умножать на ставку новой модели.
Для предварительной оценки используйте счётчик, предназначенный для нужной модели, если такой инструмент предоставляет поставщик. Для фактического расчёта сохраняйте статистику выполненного запроса и запись о списании. Например, OpenAI описывает отдельный метод подсчёта входа; его наличие у посредника нужно проверить отдельно. Разница между оценкой и счётом может включать служебные инструкции и дополнительные данные, которые отправляет приложение.
Из чего складывается вход
Вход — это не только последняя фраза пользователя. В него могут входить системные инструкции, предыдущая переписка, описание инструментов, извлечённый текст файлов и результаты предыдущих действий. Если приложение каждый раз передаёт весь диалог, короткий новый вопрос сопровождается растущей историей.
Условный пример: пользователь просит уточнить одну строку длинного договора, но приложение повторно отправляет весь договор и переписку. Считать расход по длине последнего вопроса в таком случае неверно. Чтобы понять причину большого входа, нужно посмотреть состав запроса, а не только экран чата.
Не удаляйте историю механически ради уменьшения числа токенов. Модель может потерять условия задачи и начать ошибаться, что приведёт к повторным запросам. Лучше определить, какие сведения нужны для следующего шага, и проверить результат после изменения способа передачи контекста.
Разберите статистику одного запроса
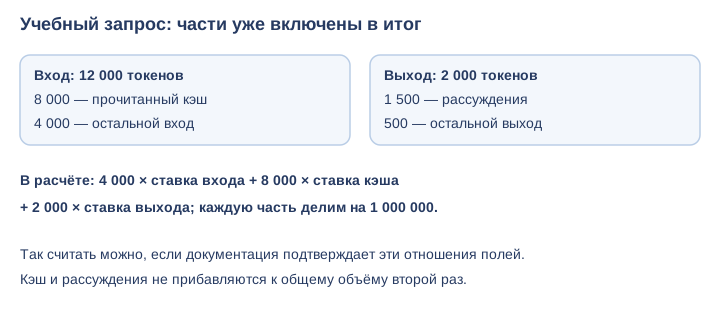
Учебный пример: API сообщает 12 000 входных и 2 000 выходных токенов. В детализации указаны 8 000 токенов прочитанного кэша и 1 500 токенов рассуждений. Предположим, документация этого API прямо говорит, что обе детализации уже входят в соответствующие общие числа.
| Часть запроса | Как получить объём | Что пойдёт в расчёт |
|---|---|---|
| Вход без чтения кэша | 12 000 − 8 000 | 4 000 токенов |
| Чтение кэша | Отдельная часть входа | 8 000 токенов |
| Оплачиваемый выход | Весь выход, включая рассуждения | 2 000 токенов |
Кэш — повторно используемая часть входных данных, которую поставщик может тарифицировать иначе. Рассуждения — внутренняя обработка задачи моделью; весь её объём не обязательно виден в ответе. Здесь прибавление 1 500 к 2 000 повторно учло бы одни и те же токены.
Для своего запроса найдите в документации определения полей usage — статистики расхода — и сначала выпишите их отношения. У другого API запись кэша может иметь отдельный счётчик. Если неясно, входит ли детализация в общую сумму, не складывайте поля наугад: сохраните обезличенный ответ и уточните правило у поставщика.
Базовая формула и её границы
Для текстового запроса с раздельными ставками и кэшем расчёт можно представить так:
стоимость =
  обычный вход / 1 000 000 × ставка обычного входа
  + кэшированный вход / 1 000 000 × ставка чтения кэша
  + оплачиваемый выход / 1 000 000 × ставка выхода
  + отдельно тарифицируемые операции
В учебном примере в формулу войдут 4 000 обычных входных, 8 000 кэшированных и 2 000 выходных токенов. Каждую часть умножьте на свою ставку; одной общей ставки здесь нет.
Обычный и кэшированный вход должны быть непересекающимися величинами. Если input_tokens уже включает кэш, сначала выделите его часть по правилам API; иначе кэш будет посчитан дважды. Аналогично проверьте, включены ли рассуждения в указанный выход.
Формула требует уточнения для записи кэша, инструментов, изображений, аудио и других способов тарификации. Не подставляйте в неё единицы, которые сервис считает иначе. Сравнение допустимо, только когда совпадают модель, продукт, единица и вариант операции.
Ставки берите из текущего тарифа поставщика и проверяйте дату. Если списываются Caps или другие внутренние единицы, сначала посчитайте операцию в них, а затем переведите по курсу доступного вам пакета. Номиналы разных внутренних валют напрямую несопоставимы.
Выход и рассуждения
Видимый ответ может быть короче оплачиваемого вывода: OpenAI включает в общий выход и невидимые токены. Рассуждающие модели расходуют токены на внутреннюю обработку, и способ их отражения нужно смотреть в статистике конкретного API. Отсутствие длинного текста на экране не доказывает, что запрос был коротким по счёту.
Не прибавляйте поле с рассуждениями к общему выходу автоматически. В одной схеме оно может быть детализацией уже учтённого объёма, в другой потребуется отдельное правило поставщика. Сверяйте описание полей и итоговое списание на небольшом примере.
Настройка глубины рассуждения тоже зависит от модели. Например, у GPT-6.1 Sol нет уровней none и minimal, поэтому универсальная команда «выключить рассуждения для экономии» к ней не подходит. Если меняете допустимый уровень, повторите проверку качества на той же задаче.
Контекстное окно и тарифный порог
Контекстное окно ограничивает объём информации, доступный модели при запросе. Тарифный порог определяет, когда меняются условия оплаты. Эти числа могут быть разными: запрос помещается в окно, но уже обслуживается по другой ставке.
У GPT-6.1 Sol отдельное условие длинного входа начинается выше 272 тысяч токенов. У Claude Haiku 5.5 в документации указан порог входа больше 100 тысяч. Проверяйте, применяется ли повышенная ставка ко всему запросу, а не предполагаемому «хвосту» сверх порога.
У Gemini 4 Argon вход, рассуждения и ответ делят единое окно. Поэтому при оценке размера документа нужно оставить место для завершения работы. Условия посредника могут дополнительно ограничивать доступный объём и методы длинного вывода.
Для прямого DeepSeek API на стоимость также влияет тарифный период. Он не определяется длиной текста и не переносится автоматически на посредника. В гайде о DeepSeek разобраны расписание и границы его применения.
Сверьте расчёт с реальной операцией
Выберите небольшой запрос с понятным результатом и сохраните модель, дату, параметры и статистику. Сопоставьте её с записью в кабинете, включая дополнительные операции. Если цифры расходятся, сначала выясните единицы и состав полей, затем проверяйте собственную арифметику.
Для нескольких моделей сравнивайте одну и ту же завершённую задачу. Суммируйте расход всех попыток, необходимых для принятого результата. Отдельно учитывайте время ручной правки, если именно оно определяет удобство работы.
Исторический расчёт сохраняйте вместе с прежней моделью, тарифом и датой. Новая версия может изменить токенизацию, длину ответа или число повторов. Поэтому актуализация начинается с нового измерения, а не с замены имени в старой таблице.
Вопросы и ответы о расходах
Можно ли заранее узнать точную цену длинного ответа?
Размер входа можно оценить, но будущий вывод и дополнительные действия заранее известны не всегда. Задайте разумные ограничения и бюджет, а окончательный расход проверяйте по статистике и списанию.
Почему одинаковый запрос стоит по-разному?
Проверьте модель, параметры, попадание в кэш и тарифный период. Содержимое ответа и оплачиваемые рассуждения также могут отличаться, даже если видимый вопрос не изменился.
Большое окно означает, что модель хорошо прочитает весь документ?
Окно задаёт технический предел, но не гарантирует качество извлечения каждого факта. Проверьте нужные сведения и ссылки на источник на собственных примерах, особенно для длинных материалов.
Что выгоднее сократить первым?
Сначала найдите фактическую причину расхода: повторяемый вход, длинный вывод или неудачные попытки. Сокращение без проверки качества может увеличить число повторов и итоговую стоимость.