Обновлено: 17 октября 2026
Это учебный расчёт для чат-бота поддержки на 50 000 диалогов в месяц. Сценарий условный, ставки взяты из сохранённого среза каталога на 12–13 июля 2026 года. Расчёт показывает расходы на ответы разных моделей; качество, стоимость внедрения и окупаемость нужно оценить на своих данных.
Предположим, чат-бот отвечает старшей моделью на все обращения: и «где мой заказ», и на вопросы о сложных сбоях. Мы посчитали, как изменится стоимость ответов, если распределить диалоги между тремя моделями. При заданных долях она снижается с 284 618 ₽ до 89 655 ₽ в месяц — на 68,5%, без учёта классификации, повторной обработки и эксплуатации.
17 октября проверена арифметика и уточнены выводы об окупаемости. Июльские модели и ставки сохранены для воспроизводимости примера; это не текущий прайс и не рекомендация выбрать именно эти модели.
01. Исходная задача
Условный онлайн-сервис использует чат-бот первой линии поддержки:
- 50 000 диалогов в месяц;
- средний диалог: 6 000 входных токенов (системный промпт, история, фрагменты базы знаний) и 1 200 выходных;
- итого в месяц: 300 млн входных и 60 млн выходных токенов;
- все запросы обслуживает флагман GPT-5.6 Sol.
Для примера взяты ставки BotHub из июльского среза. По сохранённым данным тот же объём токенов Sol стоил 252 992,40 ₽ у OpenAI и 284 617,80 ₽ у BotHub — разница 12,5%. Это отношение двух исторических сумм, а не постоянное правило ценообразования BotHub.
Задача: снизить расходы, не трогая сам продукт — меняем только то, какая модель отвечает на какой запрос.
Для нового решения возьмите актуальные ставки выбранных моделей и условия своего тарифа. Даже более дорогая исходная модель не гарантирует окупаемость маршрутизации: экономию могут поглотить повторные вызовы, проверка ответов и сопровождение.
02. Что было и что стало
Было — монолит. Пользователь → один системный промпт → GPT-5.6 Sol для 100% запросов → ответ. Флагман работает и над разбором инцидента, и над вопросом «как выйти из аккаунта».
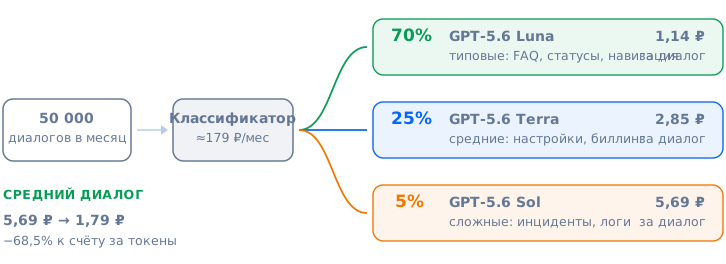
Стало — маршрутизация на три уровня. Пользователь → классификатор запроса (правила + лёгкая модель) → одна из трёх веток:
- типовые запросы → лёгкая модель GPT-5.6 Luna;
- средние → рабочая модель GPT-5.6 Terra;
- сложные → флагман GPT-5.6 Sol.
Заранее задайте правила передачи сложного обращения другой модели или человеку. Например, повторный вопрос пользователя или просьба связаться с сотрудником могут требовать такой передачи. Если первая модель уже ответила, её расход остаётся в счёте; повторную обработку нужно оплатить отдельно.
03. Что изменили
- Классификация запросов. До выбора модели обращению присваивается класс сложности. Для этого можно проверить правила по ключевым словам и разделу продукта или отдельную языковую модель. В исходном примере для классификатора на DeepSeek V4 Flash заложено около 179 ₽ в месяц; ниже это условный бюджет, а не заново подтверждённая цена.
- Три уровня моделей вместо одного. Один и тот же промпт-шаблон, разные модели: Luna, Terra, Sol.
- Правила передачи сложных случаев. Определите, когда нужен повтор на другой модели, а когда — сотрудник поддержки. Стоимость этих действий учитывайте вместе с первоначальным ответом.
04. Как расходится трафик
Доли классов выбраны для учебного расчёта. Они не получены из реальной поддержки; структуру ваших обращений нужно определить по собственным диалогам.
| Класс запроса | Примеры | Модель | Доля | Цена диалога* |
|---|---|---|---|---|
| Типовые | FAQ, статусы заказов, навигация по продукту | GPT-5.6 Luna | 70% | 1,14 ₽ |
| Средние | Настройки, биллинг, ошибки по инструкции | GPT-5.6 Terra | 25% | 2,85 ₽ |
| Сложные | Инциденты, разбор логов, нестандартные случаи | GPT-5.6 Sol | 5% | 5,69 ₽ |
| Средневзвешенно | 100% | 1,79 ₽ |
* При профиле 6 000 входных + 1 200 выходных токенов, по ценам BotHub. Для сравнения: диалог целиком на Sol стоит 5,69 ₽.
05. Динамика стоимости
Цены, по которым считаем (BotHub, минимальные в нашем каталоге на 12–13 июля 2026 года, ₽ за 1 млн токенов, вход / выход): Sol — 431,24 / 2 587,43; Terra — 215,62 / 1 293,72; Luna — 86,25 / 517,49.
| Уровень | Диалогов | Токены вход/выход, млн | Стоимость, ₽/мес | Доля затрат |
|---|---|---|---|---|
| Лёгкий (Luna) | 35 000 | 210 / 42 | 39 847,08 | 44,4% |
| Средний (Terra) | 12 500 | 75 / 15 | 35 577,30 | 39,7% |
| Флагман (Sol) | 2 500 | 15 / 3 | 14 230,89 | 15,9% |
| Итого «стало» | 50 000 | 300 / 60 | 89 655,27 | 100% |
| Было: всё на Sol | 50 000 | 300 / 60 | 284 617,80 | — |
| Экономия | 194 962,53 в месяц (−68,5%) |
Средняя стоимость ответов на диалог падает с 5,69 ₽ до 1,79 ₽. Если ставки, объём и доли не меняются 12 месяцев, разница составляет около 2,34 млн ₽ за год — до дополнительных расходов. В структуре «стало» 5% сложных диалогов требуют 15,9% бюджета на ответы.
При долях 50/35/15 стоимость ответов составит 120 963,09 ₽ в месяц. Разница с обработкой всего потока на Sol — 163 654,71 ₽, или 57,5%. Она зависит от всех трёх долей и ставок, а не только от числа типовых обращений.
К основной таблице нужно добавить расходы на классификацию. С условными 179 ₽ итог для долей 70/25/5 составит 89 834,27 ₽, а разница с исходным вариантом — 194 783,53 ₽. Это ещё не чистая экономия: повторные вызовы, эксплуатация и труд команды здесь не оценены.
Вариант с Claude Haiku 4.5 на лёгком уровне (у неё дешевле выход: 86,25 / 431,24 ₽ за 1 млн через BotHub): диалог — 1,03 ₽, месяц целиком — 86 032,77 ₽, экономия 198 585,03 ₽ (−69,8%). Здесь тоже посчитаны только ответы. Перед выбором сравните их качество на своих обращениях и полные расходы обоих вариантов.
06. Качество ответов: риски и контроль
Качество ответов в этом кейсе не измерялось. До запуска проверьте на своих обращениях, какие ошибки допускает каждая модель и правильно ли классификатор выбирает исполнителя. Для проверки нужны три вида наблюдений:
- Ошибки ответов. Проверяйте соблюдение условий компании, полноту ответа и необходимость участия сотрудника. Дорогая модель тоже может ошибаться.
- Ошибки выбора модели. Разметьте обращения вручную и сравните свою оценку с решением классификатора. До увеличения доли автоматических ответов проверьте не только стоимость, но и последствия неверного выбора.
- Изменения после запуска. Следите за повторными обращениями, передачами сотрудникам, ошибками и оценками пользователей. Сравнивайте их с работой прежнего бота.
Перенаправить один процент потока — 500 диалогов — сразу на Terra вместо Luna стоит дополнительно 853,85 ₽ при профиле из кейса. Если Luna уже ответила и те же диалоги затем целиком обрабатывает Terra, доплата составит 1 423,09 ₽: первый вызов уже оплачен. При повторе с дополнительной историей расход может быть выше.
07. Стек и модели
- Доступ к моделям — BotHub в исходном срезе кейса. Для новой интеграции проверьте наличие нужных версий, методы API и условия оплаты; ставки пересчитайте для доступного вам пакета. Можно сравнить и другой прокси-сервис.
- Классификатор — правила, языковая модель или отдельная обученная программа. Условные 179 ₽ в этом примере не заменяют проверку фактического расхода выбранного способа.
- Наблюдаемость: логирование класса запроса, модели, токенов и стоимости на каждый диалог — без этого экономику не проверить.
08. Учебный план внедрения
- Недели 1–2 — аудит. Выгрузка и разметка выборки диалогов, реальная структура классов, базовые метрики стоимости.
- Неделя 3 — первая версия классификатора. Правила и модель, прогон на исторических данных, A/B на 10% трафика.
- Неделя 4 — расширение. До 50% трафика, уточнение правил передачи сложных обращений, сверка качества на выборке.
- Неделя 5 — решение о расширении. Переход к большей доле трафика только после проверки качества, расходов и возможности вернуть прежний способ обработки.
- Неделя 6 — подведение итогов. Отчёт «план/факт» по экономии, инструкция на случай ухудшения качества ответов, регулярный пересмотр цен.
Шесть недель и указанные доли — пример последовательности, а не оценка сроков для вашей команды. Переход к следующему этапу зависит от результатов проверки; при росте ошибок расширение нужно остановить.
09. Ограничения результата
- Это расчёт, а не измерение. Ни один из показателей не наблюдался на реальном трафике; эффект зависит от вашей структуры обращений и качества классификатора.
- Цены зафиксированы на 12–13 июля 2026 года. Для текущих таблиц НейроНав берёт ставки BotHub из его публичного API каталога, а стоимость Caps переводит в деньги по условиям подходящего пакета. Историческая разница 12,5% не заменяет такую проверку; порядок расчёта описан в методике.
- Расчёт не включает дополнительные сборы за запросы и пополнение. Перед новым расчётом проверьте, что входит в опубликованную ставку: налог или комиссию, которые уже включены, нельзя прибавлять повторно.
- Профиль токенов одинаков для всех уровней (6 000 + 1 200). На реальных обращениях он может различаться; объёмы нужно измерить отдельно для каждой группы.
- Разделение 70/25/5 — допущение. Основная таблица считает только ответы; условный бюджет классификации добавлен отдельно. Повторная обработка, разработка, сопровождение и проверка ответов не измерялись.
10. Методика расчётов
Формула одна: стоимость диалога = (входные токены × цена входа + выходные токены × цена выхода) / 1 000 000, месяц = сумма по всем диалогам. Пример для Sol: 6 000 × 431,24 / 10⁶ + 1 200 × 2 587,43 / 10⁶ = 2,59 + 3,10 = 5,69 ₽.
«Было» = 50 000 × 5,692356 = 284 617,80 ₽. «Стало» = 35 000 × 1,138488 + 12 500 × 2,846184 + 2 500 × 5,692356 = 39 847,08 + 35 577,30 + 14 230,89 = 89 655,27 ₽.
Все промежуточные значения считались без округления; округляли только при выводе. Исторический срез цен сохранён выше; текущие правила сравнения — в методике.
Для оценки окупаемости вычтите из экономии на ответах все дополнительные ежемесячные расходы: классификацию, оплаченные повторы, инфраструктуру, сопровождение и проверку ответов. Если разница положительна, разделите разовые затраты на внедрение на эту сумму — получите расчётный срок окупаемости в месяцах. Если разница нулевая или отрицательная, внедрение по этому сценарию не окупается. Качество при этом должно оставаться приемлемым: денежный расчёт не заменяет его проверки.
11. Повторите расчёт на своих цифрах
Для каждой модели отдельно посчитайте месячный объём входных и выходных токенов и подставьте его в калькулятор стоимости. Затем сложите расходы всех веток и добавьте классификацию, повторы и эксплуатацию. Калькулятор использует цены из текущего каталога; ставки июльского примера нужно считать по формулам выше.
Цены в расчёте — BotHub; альтернативные прокси и их наценки — в каталоге сервисов. Как выбрать прокси под себя — в гайде «Как выбрать API-прокси».
12. С чего начать у себя
Сначала оцените, какую работу можно передать другой модели без неприемлемых ошибок. Затем сравните стоимость всех оплаченных вызовов, включая классификацию и повторы. Выгодный тариф не поможет, если проверка и исправление ответов потребуют больше труда.
Начните с выборки своих диалогов: разметьте типовые и сложные случаи, отдельно отметьте обращения, где нужен человек. Для каждого способа обработки запишите расход токенов и результат проверки. Универсального порога в 50% типовых запросов нет: решение зависит от качества, разницы ставок, повторной обработки и расходов команды.
Вопросы и ответы о маршрутизации
Не станет ли бот заметно хуже отвечать?
Это нужно проверить на ваших обращениях: в кейсе нет измерений качества. Сравнивайте ошибки, повторные обращения и передачи сотрудникам с прежним ботом. Увеличивайте долю маршрутизируемых запросов только при приемлемом результате; стоимость потери клиента здесь не оценивалась.
Сколько стоит сам классификатор?
В исходном примере заложены условные 179 ₽ в месяц на классификацию 50 000 обращений. Добавление этой суммы к основным ответам даёт 89 834,27 ₽ вместо 89 655,27 ₽; прочие расходы ещё нужно учесть. Для своего расчёта измерьте фактические списания классификатора и добавьте стоимость его настройки и сопровождения — правила без вызова модели тоже требуют работы команды.
Экономия зависит от того, что доли ровно 70/25/5?
Результат зависит от всех долей, ставок и объёма токенов. При распределении 50/35/15 ответы стоят 120 963,09 ₽, экономия относительно всех ответов на Sol — 163 654,71 ₽, или 57,5%. Чтобы оценить окупаемость, дополнительно учтите классификацию, повторы, эксплуатацию и внедрение; одного пересчёта токенов недостаточно.
Почему считали по ценам прокси, а не по официальным?
Кейс описывает расчёт через посредника по июльскому срезу каталога. По тем же историческим данным стоимость токенов Sol составляла 252 992,40 ₽ у OpenAI и 284 617,80 ₽ у BotHub — разница 12,5%. Сегодняшнюю доступность, оплату и цену нужно проверять отдельно; постоянной наценки BotHub эта цифра не задаёт.
Подойдёт ли схема не для поддержки?
Её можно проверить для заявок, писем, модерации или подготовки черновиков, если у задач различаются требования к обработке. Сначала сравните качество и полные расходы на своих примерах. Даже при большом числе типовых запросов дополнительная система может не окупиться.